資料検索

 大学検索

 資料検索

AIが人の感情を判断するには? マルチモーダル学習の可能性
複数の感覚情報を組み合わせる
主に画像認識の分野で発展してきた深層学習が、音声認識や自然言語理解にも使われるようになりました。さらに、人間が視覚や聴覚など複数の感覚を使って物事を判断しているのと同じように、さまざまな種類(モーダル)の情報を組み合わせる「マルチモーダル深層学習」の研究も行われています。ただ、画像と音声ではデータの種類も情報量も大きく異なり、それらをAIが統合して活用するのは容易ではありません。
表情だけではわからない
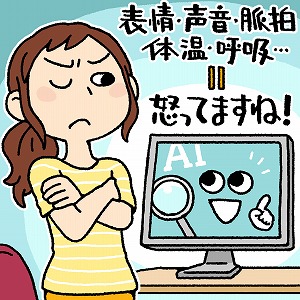
この技術の活用例が、人の表情や声の抑揚を組み合わせて感情を推定するAIです。表情だけでは人の感情は必ずしも読み取れません。笑顔で怒る人もいれば、声の調子や会話の流れによって受ける印象が変わることもあります。さらに、感情の表し方は文化によって異なり、感情の種類そのものが地域によって違うという指摘もあります。そこで、その人の状況や音声、話している内容などを組み合わせることで、より正確に感情を判断できると期待されています。
AIに人の感情とその表現を教えるためには、感情のラベルを付けた映像や音声のデータが必要です。作成する際には、人が他者の感情をどのように読み取っているのかという心理学の知見も必要とされます。
音声通話で感情を推定
人は猫の写真を見て、鳴き声を思い浮かべたり、鳴き声を聞いて姿を想像したりと、異なる種類の情報を頭の中で結び付けられます。同じような機能をAIで実現するため、画像と音声に共通する「意味概念」を学習させる研究も進められています。
実現すれば、音声通話のように相手の顔が見えない状況でも、声のトーンから表情や感情の推定が可能になります。また、通常のカメラ画像だけでなく、赤外線センサや距離を測る深度センサなど、性質の異なる映像データを組み合わせてAIに判断させる研究も進められています。研究が進めば、データが一部欠けていても別の情報から補うシステムも可能になるかもしれません。
※夢ナビ講義は各講師の見解にもとづく講義内容としてご理解ください。
※夢ナビ講義の内容に関するお問い合わせには対応しておりません。
先生情報 / 大学情報